


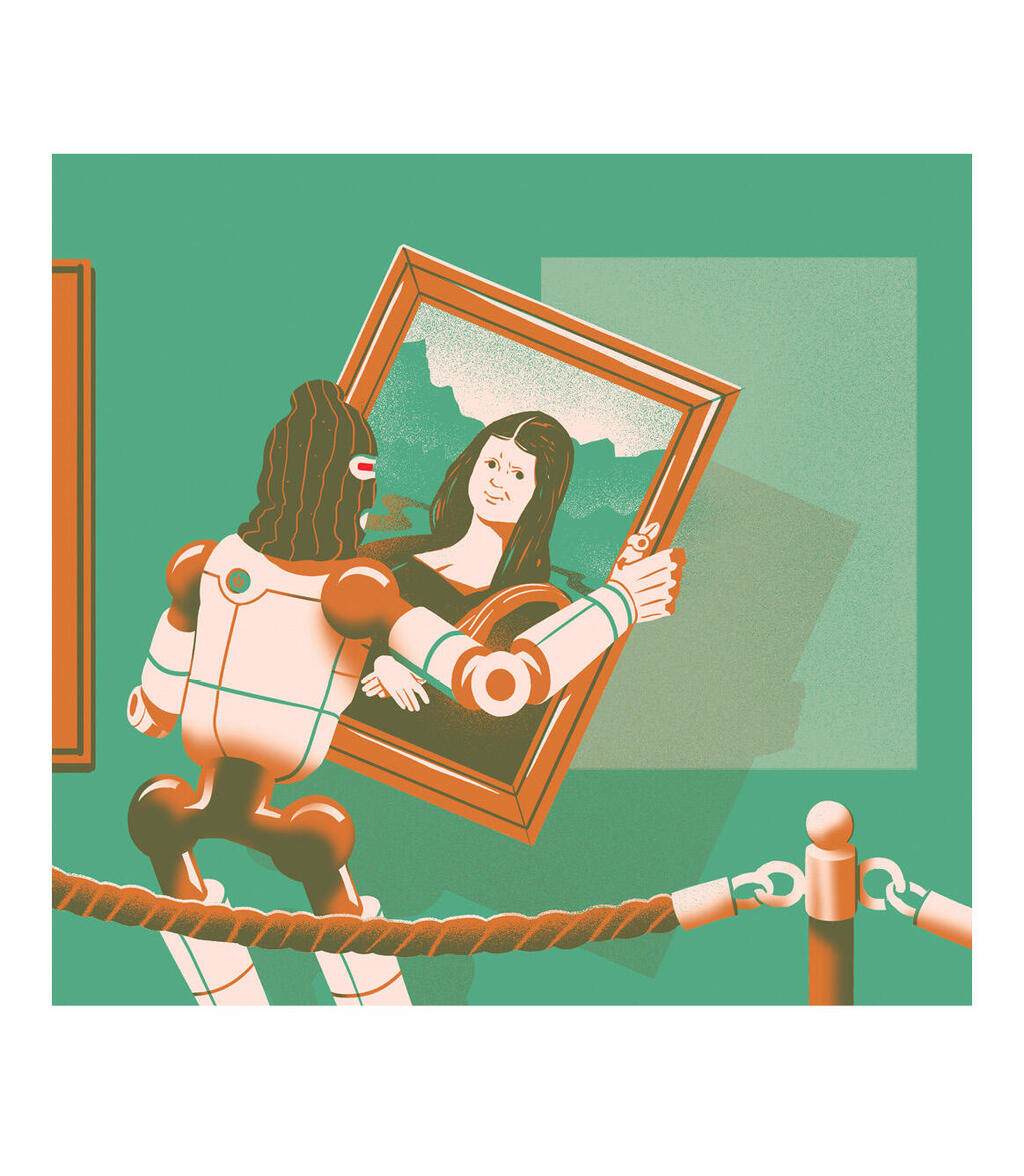
הגזל הגדול ביותר של עבודה אנושית בהיסטוריה", כך תיאר ברנט הכט, בכיר במיקרוסופט, את השימוש הנרחב ביצירות אנושיות לצורך אימון מודלים של בינה מלאכותית. הדברים נכתבו במסמך פנימי של החברה ונחשפו בספטמבר במסגרת תביעת זכויות יוצרים שהגישו "הניו יורק טיימס" וגופי תקשורת אחרים נגד מיקרוסופט ו־OpenAI, בטענה שהן עשו שימוש במיליוני כתבות ללא רשותם כדי לאמן את המודלים שלהן. והכט אינו היחיד שהתריע. מהמסמכים עולה כי עובדים ובכירים נוספים בשתי החברות חששו שהמערכות שהם מפתחים עלולות לערער את הבסיס הכלכלי של התעשיות, שעל הידע שלהן הן נשענות.
שורש המחלוקת טמון באופן שבו התפתחה תעשיית הבינה המלאכותית, וזהו גם החטא הקדמון שלה. אימון מודלים מתקדמים דורש כמויות עצומות של דאטה, והאינטרנט סיפק לחברות הטכנולוגיה מאגר חסר תקדים. ספרים, מאמרים, תמונות, מוזיקה — יצירות שחלק מהן מוגנות בזכויות יוצרים, וחלק מהן נוצרו בשנים של מחקר, יצירה ועמל אנושי — נאספו בהיקפים עצומים והפכו לחומרי גלם של מערכות מסחריות, במקרים רבים ללא ידיעת היוצרים וללא תמורה.
עבור גופי תוכן האיום נוגע גם ליכולתם להמשיך להתקיים מבחינה כלכלית. כשעמוד תוצאות החיפוש בגוגל ממקם בראשו תוצאות חיפוש של מודל AI, שנותנות למשתמשים תשובות לשאלות שלהם — למה שהם ייכנסו לאתר שעשה את המחקר הנדרש? ולמה שהם ישלמו על התוכן הזה באתר, אם הוא ניתן להם בחינם מהמודל? ואכן, לפי נתוני חברת האנליטיקה Chartbeat, שפורסמו בדו"ח של מכון רויטרס לחקר העיתונות, התנועה שהגיעה לאתרי תוכן מחיפוש אורגני בגוגל צנחה ב־33% ברחבי העולם בשנים 2024–2025. לא בכדי טוען "הניו יורק טיימס" בתביעה שמערכות ה־AI מתחרות בו ופוגעות במקורות ההכנסה שלו ממנויים ומפרסום.
מהם גבולות השימוש ההוגן
בלב המאבק המשפטי עומד העיקרון "שימוש הוגן" (Fair Use), המתיר, לפי הדין האמריקאי ובנסיבות מסוימות, להשתמש ביצירות מוגנות בזכויות יוצרים ללא אישור בעלי הזכויות. חברות הטכנולוגיה טוענות שאימון מודלים דומה במהותו ללמידה אנושית: כפי שסופר קורא מאות ספרים, לומד מהם ומפתח סגנון משלו, כך גם מודל בינה מלאכותית לומד דפוסים וקשרים מתוך יצירות קיימות. אלא שההיקף והמהירות משנים את כללי המשחק. מערכת אחת מסוגלת לעבד מיליוני יצירות ולייצר על בסיסן תכנים שעשויים להתחרות ביצירות המקוריות.
עד כה, הפסיקות בבתי המשפט בארצות הברית אינן אחידות ותלויות נסיבות, וממחישות עד כמה חוקי זכויות יוצרים מתקשים להתמודד עם הטכנולוגיה החדשה. כך למשל, ביוני 2025 ניתנו בקליפורניה, בהפרש של יומיים בלבד, שתי החלטות שונות בתביעות של סופרים שספריהם שימשו לאימון מודלים של AI ללא אישורם.
בתביעה נגד אנתרופיק, השופט השווה את האימון ללמידה אנושית וסבר שהאפשרות שהמודלים ישמשו ליצירת ספרים מתחרים אינה כשלעצמה סיבה לשלול את הגנת השימוש ההוגן. ההפרה היחידה היתה הדרך שבה הושגו הספרים: הורדת מיליוני ספרים מאתרים פיראטיים ושמירתם במאגרי החברה. "העובדה שאנתרופיק רכשה מאוחר יותר עותק של ספר שגנבה קודם לכן מהאינטרנט לא תפטור אותה מאחריות לגניבה", כתב השופט. התביעה הסתיימה בהסכם הפשרה עם הפיצוי הגדול ביותר בתולדות דיני זכויות יוצרים — 1.5 מיליארד דולר.
אבל בתביעה השנייה השופט פסק לטובת מטא בשאלת האימון של כ־200 אלף ספרים בגלל קנה המידה של התחרות. לטענתו, לא הוצגו ראיות מספקות לכך שהבינה המלאכותית תגרום ל"דילול שוק" על ידי הצפתו ביצירות דומות.
גם חברות ה־AI מודאגות
ההשלכות הכלכליות של אימון המודלים מטרידות גם את חברות הטכנולוגיה עצמן. במסמך פנימי שנחשף במסגרת התביעה הזהירו במיקרוסופט כי "מודלי שפה גדולים הם מוצר שמשמיד את שרשרת האספקה של עצמו". "לולאת האבדון" (Doom Loop) הזו, לטענתם, עלולה לפגוע הן באינטרנט והן בביצועי המודלים.
גם הנתונים שהוצגו בתביעה של גופי התקשורת ממחישים את החשש: לפי נתוני מיקרוסופט, שיעור ההקלקות על קישורים ל"הניו יורק טיימס" ב־Copilot (בעבר נקרא Bing Chat) נמוך ב־87%–93% בהשוואה לחיפוש רגיל ב־Bing. פחות כניסות משמען פחות הכנסות מפרסום וממנויים, ובהמשך גם פחות משאבים למימון העיתונאים שיכתבו את הכתבות הבאות. במילים אחרות, ככל שביצועי מערכות הבינה המלאכותית משתפרים, כך הן עלולות להחליש את התעשיות שמייצרות את הידע שעליו הן נשענות, ובכך לפגוע גם במקור הידע שיזין את הדורות הבאים של המודלים.
מהמסמכים עולה גם מלכוד כלכלי עמוק יותר: לכל חברת AI יש תמריץ להשתמש בכמה שיותר תוכן ולשלם עליו כמה שפחות, אף שהתעשייה כולה תלויה בהמשך קיומם של מי שמייצרים אותו בטווח הארוך. לתאגידי המדיה הגדולים יש כוח מיקוח, משאבים ומחלקות משפטיות שמאפשרים להם לנהל משא ומתן על עסקאות של מיליוני דולרים. לעומתם, יוצרים עצמאיים, אמנים, עיתונאים וחוקרים, שגם יצירותיהם שימשו לאימון המודלים, מתקשים הרבה יותר לדרוש תמורה. כך עלול להיווצר שוק שבו התגמול עבור יצירה אינו משקף בהכרח את ערכה או את היקף השימוש בה, אלא מושפע במידה רבה מכוח המיקוח של בעלי הזכויות.
ההשלכות של המאבק הזה אינן מסתכמות בפגיעה ביוצרים של היום. הן נוגעות גם לידע שעדיין לא נוצר. תחקיר עיתונאי לעתים דורש חודשים של עבודה, מחקר מדעי עשוי להימשך שנים, וגם כתיבת ספר או פיתוח תוכנה מחייבים השקעה של זמן, משאבים ונטילת סיכון כלכלי. היכולת להפיק תמורה כלכלית מהתוצרים הללו היא חלק ממה שמאפשר לממן את היצירה והמחקר הבאים. אבל כשמערכות בינה מלאכותית מסוגלות להפיק מהם ערך מסחרי ולהציע חלופות זמינות, הן שוחקות את התמריץ להשקיע ביצירה מקורית מלכתחילה.
זכויות יוצרים נועדו לאזן בין הפצת ידע לבין עידוד היצירה, וכעת, כשהטכנולוגיה מסוגלת להפיק ערך מסחרי מכמויות עצומות של יצירה אנושית, האיזון הזה עומד למבחן. בתי המשפט יידרשו להכריע אילו שימושים ביצירות מוגנות מותרים, ומתי השימוש בהן מהווה הפרת זכויות יוצרים המזכה בפיצוי. כך או כך, ייתכן שהמחיר הכבד ביותר של "הגזל הגדול ביותר בהיסטוריה של עבודה אנושית" יימדד במה שלעולם לא ייחקר ולא יתגלה.
הכותבת היא מומחית אינטראקציית אדם־AI



